
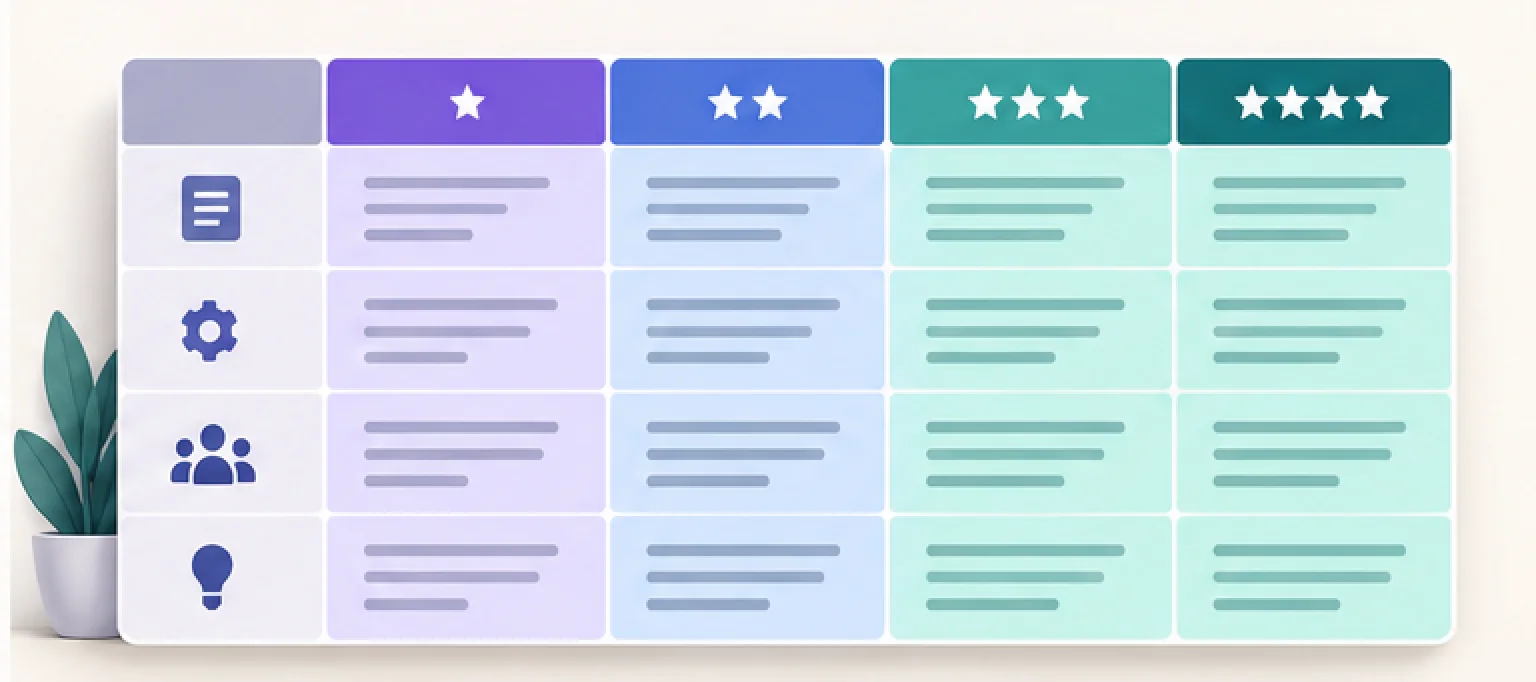
روبرک را با معیار قابل مشاهده و توصیف متمایز سطحها بسازید؛ وزن و مرز نمره را شفاف و ارزیابها را با نمونههای مرزی کالیبره کنید.
روبرک ارزشیابی معیارهای قابل مشاهده را در ردیف و سطحهای کیفیت را در ستون تعریف میکند تا ارزیاب و یادگیرنده بدانند تفاوت عملکرد ضعیف، قابل قبول و قوی چیست. Labelهایی مثل «عالی/خوب» بدون توصیف Evidence، شفافیت و همسانی نمیسازند.
روبرک ارزشیابی چیست؟
روبرک تحلیلی برای هر معیار جدا امتیاز میدهد؛ روبرک کلنگر یک توصیف کلی برای کل کار دارد. برای بازخورد و تشخیص نقطه بهبود، نوع تحلیلی معمولاً اطلاعات بیشتری میدهد.
قالب روبرک تحلیلی
| معیار | وزن | سطح ۴ | سطح ۳ | سطح ۲ | سطح ۱ |
|---|---|---|---|---|---|
| Evidence متمایز |
هر سلول باید کیفیت قابل مشاهده را توصیف کند، نه شخصیت یا تلاش فرضی فرد.
از هدف یادگیری به معیار
هدف: دانشجو بتواند ادعا را با شواهد مرتبط پشتیبانی کند.
معیار: کیفیت پیوند ادعا و شاهد.
نه معیار: باهوشبودن / زحمتکشیدن / متن خوب.
تعداد معیار را محدود کنید و مواردی را بسنجید که واقعاً به Outcome مربوطاند.
مثال ساختگی برای تکلیف تحلیلی
| معیار | ۴ — فراتر از انتظار | ۳ — مطابق انتظار | ۲ — درحال رشد | ۱ — نیازمند بازنگری |
|---|---|---|---|---|
| ادعا | دقیق، محدود و قابل بحث | روشن و پاسخگوی سؤال | کلی یا بخشی مبهم | نامشخص/نامرتبط |
| شاهد | چند شاهد معتبر و مستقیم | شاهد معتبر و مرتبط | شاهد کم/اتصال ناقص | بدون شاهد یا نامرتبط |
| استدلال | پیوند و محدودیت را توضیح میدهد | پیوند ادعا/شاهد را توضیح میدهد | بیشتر خلاصه است | جهش منطقی/بدون توضیح |
| ساختار | ترتیب تصمیمساز و انتقال روشن | ساختار قابل دنبالکردن | چند گسست | دنبالکردن دشوار |
مرز ۳ باید همان استاندارد مورد انتظار باشد؛ سطح ۴ فقط «کلمات بیشتر» نیست.
نوشتن Descriptor
برای هر سطح، این ابعاد را آگاهانه تغییر دهید:
- دقت؛
- کاملبودن؛
- ارتباط؛
- استقلال؛
- پیچیدگی Context؛
- سازگاری؛
- کیفیت Evidence.
یک معیار را با چند سازه نامرتبط شلوغ نکنید؛ در غیر این صورت معلوم نیست نمره برای کدام بخش است.
وزن و امتیاز
وزن باید اهمیت Outcome را نشان دهد، نه آسانی سنجش. اگر سطحها ۱ تا ۴ هستند:
امتیاز معیار = سطح / 4 × وزن
امتیاز کل = مجموع امتیاز معیارها
قبل از استفاده، تبدیل سطح به نمره، حد قبولی و Rule گردکردن را شفاف کنید. «صفر» فقط با تعریف روشن برای عدم ارائه/عدم وجود Evidence.
کالیبراسیون ارزیابها
- دو یا سه نمونه مرزی انتخاب کنید.
- ارزیابها مستقل نمره دهند.
- اختلاف را در سطح Criterion بررسی کنند.
- Descriptor مبهم را اصلاح کنند.
- Anchor نمونه نگه دارند.
- در میانه تصحیح Drift را دوباره کنترل کنند.
هدف فقط توافق عددی نیست؛ فهم یکسان از Evidence و مرز کیفیت است.
آزمون با یادگیرنده
روبرک را پیش از تکلیف نشان دهید و بخواهید یک نمونه را با آن نمره دهد. اگر اصطلاح یا مرز قابل فهم نیست، بازنویسی کنید. روبرک نباید راهحل واحد خلاقیت را تحمیل کند، مگر Outcome واقعاً همان باشد.
انصاف و دسترسپذیری
- Criterion را به هدف یادگیری وصل کنید؛
- لهجه/سبک را بیربط امتیاز ندهید؛
- Accommodation را طبق سیاست رعایت کنید؛
- نمونهها تنوع معتبر داشته باشند؛
- Bias نام/هویت را تا حد ممکن کم کنید؛
- مسیر اعتراض و Feedback روشن باشد.
نسخه روبرک و Anchorها را در یادداشت، فرایند کالیبراسیون را در پروژه و اصلاحها را در تسک نگه دارید.
چکلیست طراحی
- معیارها به Outcome وصلاند.
- رفتار/Evidence قابل مشاهدهاند.
- سطح ۳ یا استاندارد انتظار روشن است.
- مرز سطحها واقعاً متمایز است.
- معیار دوگانه شکسته شده است.
- وزن با اهمیت همخوان است.
- Anchor sample وجود دارد.
- ارزیابها کالیبره شدهاند.
- یادگیرنده روبرک را میفهمد.
- انصاف و Accommodation بررسی شدهاند.
پرسش های متداول
روبرک تحلیلی و کلنگر چه فرقی دارند؟
تحلیلی هر معیار را جدا سطحبندی میکند؛ کلنگر یک قضاوت کلی میدهد و جزئیات Feedback کمتر است.
سطحها را فقط عالی، خوب و ضعیف بنویسیم؟
خیر؛ باید Evidence و تفاوت قابل مشاهده هر سطح را توضیح دهید.
چطور همسانی ارزیاب را بهتر کنیم؟
نمونههای مرزی را مستقل نمره، اختلاف را بررسی و Descriptor/Anchor را پیش و حین تصحیح کالیبره کنید.
جمعبندی
روبرک خوب هدف را به معیار و معیار را به Evidence قابل مشاهده تبدیل میکند. سطحها را با مرزهای واقعی بنویسید، وزن را شفاف و با نمونه کالیبره کنید و روبرک را برای Feedback و انصاف بیازمایید.