
ChatGPT و Gemini را با یک PDF فارسی و پاسخ معیار مقایسه کردیم؛ روش سنجش پوشش، عددها، عدم قطعیت و توهم را نیز قدم به قدم می بینید.
بهترین هوش مصنوعی برای خلاصهسازی PDF فارسی را نمیتوان فقط از روی فهرست قابلیتها انتخاب کرد. ابزار باید روی همان نوع سند شما آزمایش شود: متن فارسی را درست بخواند، عددها را جابهجا نکند، میان «برنامه» و «نتیجه واقعی» فرق بگذارد و وقتی اطلاعاتی در فایل نیست آن را نسازد. سرعت و ظاهر پاسخ مهماند، اما یک خلاصه روان و نادرست از پاسخ کوتاه و محتاط خطرناکتر است.
برای این مقاله یک PDF دوصفحهای مصنوعی ساختیم و آن را با پرامپت یکسان در ChatGPT و Gemini اجرا کردیم. سند شامل هفت واقعیت قابل کنترل، یک جدول، چند تاریخ و یک نکته عمداً ناموجود بود. Claude را بهدلیل واردنبودن حساب در مرورگر تست نکردیم؛ بنابراین فقط قابلیتها و محدودیتهای رسمی آن را توضیح میدهیم و برای کیفیت عملی رتبه نمیدهیم.
نتیجه محدود آزمون: ChatGPT و Gemini هر هفت واقعیت را درست استخراج کردند و درباره عدد ناموجود چیزی نساختند. ChatGPT تفاوت «انتشار برنامهریزیشده» با «انتشار واقعی» و سال نامشخص را روشنتر بیان کرد؛ Gemini خلاصه کوتاهتری داد و چند خلأ موضوعی و کانال انتشار را برجسته کرد. این نتیجه فقط به همین فایل، همین پرامپت و زمان آزمون مربوط است.
بهترین هوش مصنوعی برای خلاصهسازی PDF فارسی را با چه معیاری بسنجیم؟
پیش از نام ابزار، معیارها را بنویسید. برای یک PDF آموزشی یا کاری، دستکم این شش مورد را بسنجید:
- پوشش: چند نکته اصلی سند در خلاصه آمده است؟
- صحت: عدد، نام، تاریخ و قیدها بدون تغییر منتقل شدهاند؟
- تفکیک وضعیت: برنامه، فرض، پیشنهاد و نتیجه واقعی با هم مخلوط نشدهاند؟
- کنترل توهم: ابزار درباره اطلاعات ناموجود پاسخ میسازد یا نبود آن را اعلام میکند؟
- ردیابی: میتوانید پاسخ را به صفحه یا بخش سند برگردانید؟
- قابلیت اصلاح: پرامپت و خروجی قابل تکرار و بازبینیاند؟
یک ابزار ممکن است در خلاصه روایی عالی باشد و در استخراج جدول ضعیف. دیگری ممکن است همه عددها را پیدا کند، اما متن طولانی و کماولویت بسازد. «بهترین» باید نسبت به کار شما تعریف شود.
PDF معیار چگونه ساخته شد؟
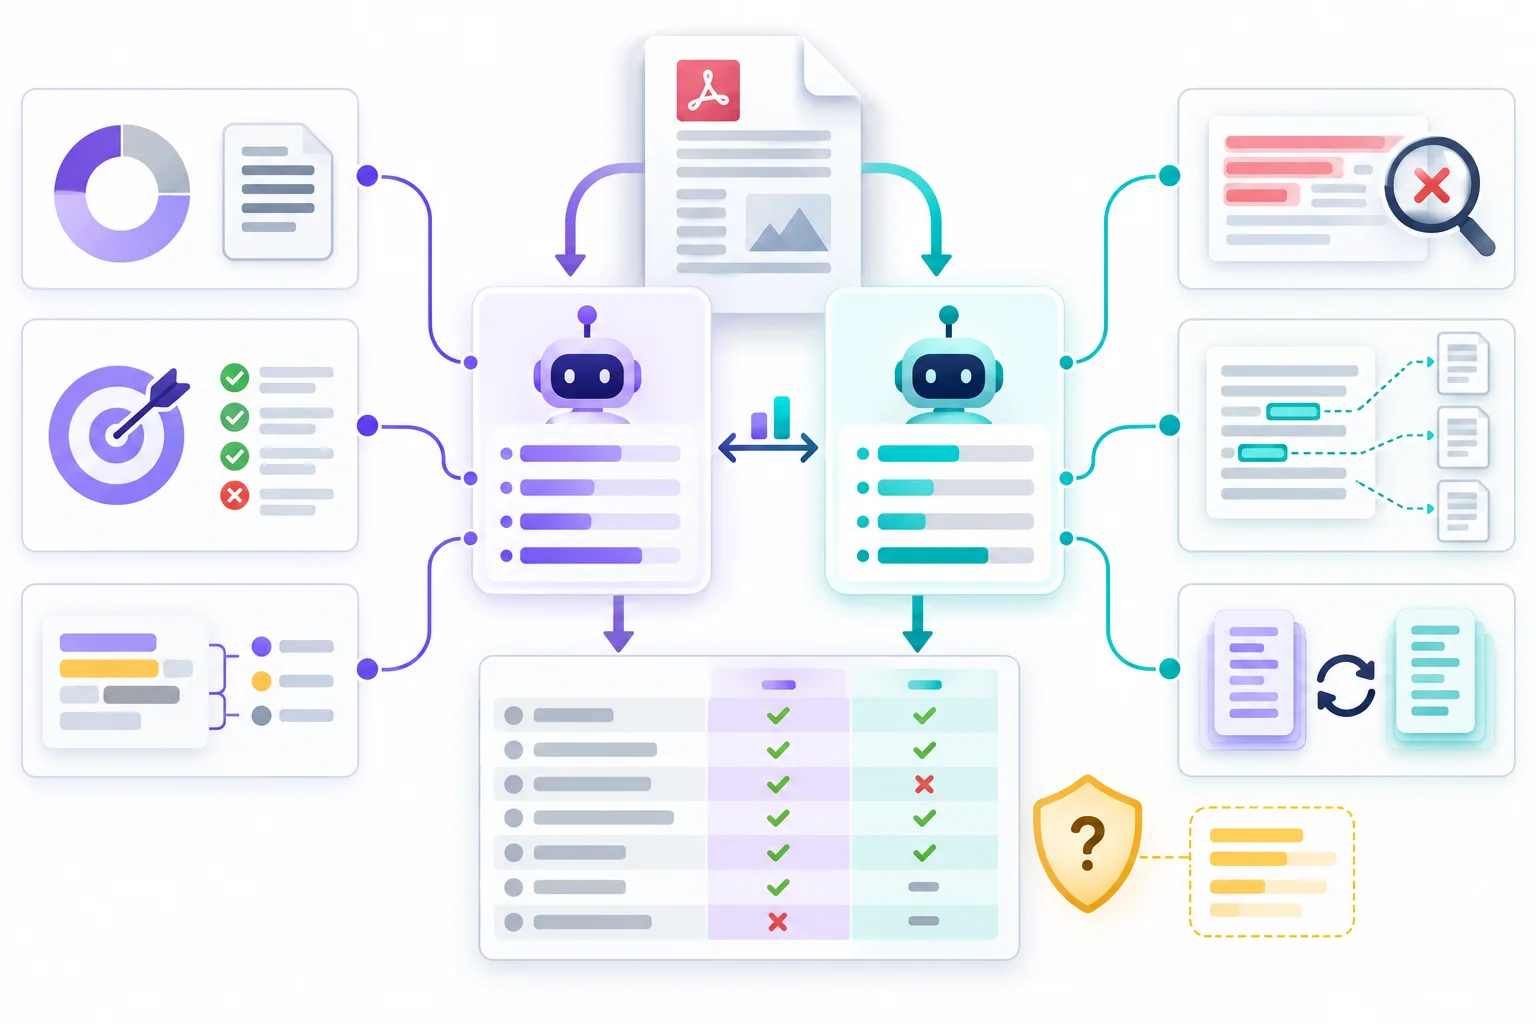
سند آزمون درباره یک پروژه محتوایی ششهفتهای با تیم چهار نفره بود. واقعیتهای کنترل چنین بودند:
| واقعیت | مقدار موجود در سند |
|---|---|
| تعداد اعضای تیم | ۴ نفر |
| بودجه مصوب | ۴۸ میلیون تومان |
| هزینه واقعی | ۴۴ میلیون تومان |
| موعد نسخه نهایی | ۲۵ آذر |
| انتشار عمومی | برای ۲۸ آذر برنامهریزی شده |
| طول هدف پیشنویس | ۱۸۰۰ تا ۲۲۰۰ واژه |
| نرخ تکمیل چکلیست | ۹۲ درصد |
در پایان سند صریحاً نوشتیم که هیچ عددی درباره بازدید ماه اول وجود ندارد. این خط برای سنجش «پاسخ ناموجود» بود. همچنین سال تاریخها و تعداد واقعی واژه نسخه نهایی را ذکر نکردیم تا ببینیم ابزار عدمقطعیت را حفظ میکند یا نه.
پرامپت از هر ابزار چهار خروجی خواست: پنج نکته کلیدی، جدول هفت واقعیت، پاسخ درباره بازدید ماه اول و فهرست اطلاعات لازم برای تصمیمگیری. دستور دادیم عدد تازه نسازد و عدمقطعیت را صریح اعلام کند.
نتیجه ChatGPT در این آزمون
ChatGPT همه هفت مقدار را درست در جدول قرار داد. ۲۸ آذر را «برنامهریزیشده» نگه داشت و تأکید کرد سند انتشار واقعی را تأیید نکرده است. بازه ۱۸۰۰ تا ۲۲۰۰ واژه را نیز «هدف پیشنویس» معرفی کرد، نه تعداد واقعی نسخه نهایی.
در بخش اطلاعات ناموجود، سال تاریخها، تفکیک هزینه، جزئیات معیار کیفیت و وضعیت انتشار واقعی را ذکر کرد. درباره بازدید ماه اول پاسخ منفی داد و به جمله صریح سند تکیه کرد. در این اجرای مشخص، عدد تازهای مشاهده نشد.
راهنمای رسمی OpenAI میگوید ChatGPT میتواند PDF را دریافت و برای خلاصه، مقایسه و استخراج اطلاعات استفاده کند. سقف فایل و دسترسی به قابلیتها به پلن و تنظیم حساب وابسته است. قابلیت درک تصویرهای داخل PDF نیز برای همه حسابها یکسان نیست؛ پس اگر نمودار و تصویر بخش مهم سند است، نوع پردازش حساب را جدا بررسی کنید.
نتیجه Gemini در این آزمون
Gemini نیز همه هفت مقدار را درست استخراج کرد، تاریخ انتشار را برنامهریزیشده نوشت و نبود آمار بازدید را صریح تشخیص داد. خروجی کوتاهتر بود و در فهرست خلأها به موضوع دقیق راهنما، کانال انتشار و شناسنامه منابع اشاره کرد.
در مقایسه همین اجرا، Gemini سال نامشخص و تفاوت «تعداد واژه هدف» با «تعداد واژه واقعی» را مانند ChatGPT برجسته نکرد؛ اما این به معنی ناتوانی همیشگی نیست. یک تغییر کوچک در پرامپت یا مدل میتواند خروجی را عوض کند. نتیجه درست این است که برای کار حساس، سؤالهای کنترل را خودتان الزام کنید.
راهنمای رسمی Google درباره Gemini امکان بارگذاری و تحلیل فایل را تأیید میکند و هشدار میدهد فایل بزرگ ممکن است باعث از دسترفتن ارتباطهای پراکنده شود. پیشنهاد رسمی برای نتیجه دقیقتر، استفاده از فایل کوچکتر یا تقسیم سند است.
Claude را چگونه ارزیابی کنیم وقتی تست نشده است؟
مستند رسمی Anthropic میگوید Claude از PDF پشتیبانی میکند و برای بعضی مدلها و PDFهای زیر ۱۰۰ صفحه میتواند عناصر بصری را نیز تحلیل کند؛ در شرایط دیگر پردازش ممکن است فقط متنی باشد. اندازه و تعداد فایل نیز محدودیت دارد.
اما وجود این قابلیتها جای آزمون را نمیگیرد. چون حساب Claude در محیط این مقاله وارد نشده بود، همان فایل و پرامپت اجرا نشد. بنابراین در جدول نتیجه، Claude را «تستنشده» مینویسیم، نه ضعیف یا قوی. این تفکیک مهم است: مستندات میگویند چه کاری ممکن است؛ آزمون میگوید در حساب و ورودی مشخص چه اتفاقی افتاد.
NotebookLM یا Gemini Notebook چه تفاوتی دارد؟
NotebookLM که در برخی صفحات رسمی با نام Gemini Notebook دیده میشود، برای کار منبعمحور ساخته شده است. میتوانید PDF را بهعنوان منبع اضافه کنید، خلاصه کل منبع را ببینید یا در گفتوگو خلاصه موضوعی بخواهید. راهنمای رسمی پیشنهاد میکند بهجای دستور کلی «این را خلاصه کن»، موضوع و نام منبع را مشخص کنید.
اگر فقط یک خلاصه سریع میخواهید، چت با فایل سادهتر است. اگر میخواهید چند منبع را کنار هم نگه دارید، پرسشهای بعدی بپرسید و پاسخ را به منبع برگردانید، Notebook ساختار مناسبتری دارد. راهنمای فارسی NotebookLM مسیر انتخاب منبع و بررسی ارجاع را دقیقتر توضیح میدهد.
برای ثبت پاسخ معیار، نسخه های مختلف خلاصه و نتیجه بازبینی می توانید از راهنمای یادداشت های نوتوا استفاده کنید تا خروجی هر اجرا از منبع اصلی جدا بماند.
ماتریس مقایسه نتیجه واقعی و قابلیت مستند
| ابزار | اجرای واقعی این مقاله | واقعیتهای هفتگانه | کنترل عدد ناموجود | نکته برجسته | محدودیت ثبتشده |
|---|---|---|---|---|---|
| ChatGPT | بله | ۷ از ۷ | موفق | تفکیک عدمقطعیت | وابستگی تحلیل بصری به حساب |
| Gemini | بله | ۷ از ۷ | موفق | پاسخ کوتاه و خلأهای عملی | تفاوت سقف و context با پلن |
| Claude | خیر | — | — | قابلیت PDF در مستندات | حساب مرورگر وارد نبود |
| NotebookLM | در این آزمون نه | — | — | محیط منبعمحور و citation | مناسب مقایسه یکبهیک این اجرا نبود |
این جدول رتبهبندی جهانی نیست. «۷ از ۷» فقط نشان میدهد مقدارهای از پیش تعیینشده این PDF در همان اجرا درست بودند. برای قرارداد، گزارش مالی یا مقاله علمی باید مجموعه آزمون بزرگتر و بازبینی انسانی داشته باشید.
پرامپت بهتر از «خلاصه کن»
یک درخواست کلی معمولاً خروجی کلی میسازد. پرامپت را به معیارهای قابل بررسی تبدیل کنید:
این PDF را فقط براساس محتوای خودش خلاصه کن.
۱) پنج نکته اصلی را بنویس.
۲) همه عددها، تاریخها و واحدها را در جدول قرار بده.
۳) برنامهها را از نتایج واقعی جدا کن.
۴) اگر پاسخ پرسشی در سند نیست، صریحاً «در سند نیست» بنویس.
۵) هیچ عدد یا ادعای تازه نساز.
۶) برای هر نکته، صفحه یا بخش مرتبط را مشخص کن.
برای سند بلند، همه نیازها را در یک مرحله نخواهید. ابتدا ساختار و سرفصلها، بعد خلاصه هر بخش و در پایان خلاصه نهایی را بخواهید. این روش امکان کنترل حذفها را بیشتر میکند.
سه آزمون برای کشف خطای خلاصه
آزمون عدد و قید
همه مبلغها، درصدها، تاریخها و واژههایی مانند «حداکثر»، «تقریبی»، «برنامهریزیشده» و «بهجز» را استخراج کنید. حذف یک قید میتواند معنی تصمیم را تغییر دهد.
آزمون پاسخ ناموجود
سؤالی بپرسید که موضوعش به سند نزدیک است اما پاسخ در فایل نیست. ابزار باید نبود اطلاعات را اعلام کند. پاسخ روان بدون منبع، علامت هشدار است.
آزمون پوشش
یک خلاصه معیار دستی از پنج تا ده نکته بسازید. خروجی ابزار را با آن مقایسه کنید و حذفهای مهم را ثبت کنید. اگر هر بار پرامپت عوض شود و معیار ثابت نباشد، مقایسه قابل تکرار نیست.
نمودار و تصویر داخل PDF را جدا بررسی کنید
بعضی ابزارها فقط متن استخراجشده PDF را میبینند و بعضی در شرایط مشخص میتوانند تصویر و نمودار را هم تحلیل کنند. اگر نتیجه کلیدی داخل نمودار است، یک سؤال مستقیم درباره همان نمودار بپرسید و سپس مقدار را با تصویر اصل تطبیق دهید.
نباید از پاسخ درست درباره متن نتیجه بگیرید که نمودار نیز دیده شده است. ممکن است عنوان نمودار در لایه متن موجود باشد ولی نقاط، رنگها یا برچسب محور پردازش نشده باشند. برای سند بصری، تصویر صفحه حساس را جداگانه نیز بررسی کنید.
محرمانگی و حق استفاده از فایل
پیش از بارگذاری PDF، مالکیت و مجوز را کنترل کنید. پرونده مشتری، پایاننامه منتشرنشده، گزارش مالی یا سند سازمانی را فقط براساس سیاست حساب و سازمان پردازش کنید. نام سرویس بهتنهایی تضمین نمیکند تنظیمات حساب شخصی و سازمانی یکسان باشند.
اگر لازم است آزمون اولیه انجام دهید، داده را مصنوعی یا ناشناس کنید. PDF معیار این مقاله دقیقاً به همین دلیل ساختگی بود. نتیجه آزمون فنی نباید با افشای داده واقعی به دست آید.
جمعبندی انتخاب ابزار
- اگر تفکیک عدمقطعیت و استخراج ساختاریافته مهم است، ابزار را با جدول واقعیت و سؤال ناموجود آزمایش کنید.
- اگر پاسخ کوتاه میخواهید، طول و ساختار خروجی را در پرامپت محدود کنید.
- اگر چند منبع و ارجاع پیوسته دارید، محیط منبعمحور مانند NotebookLM را جدا بسنجید.
- اگر PDF بصری است، نوع پشتیبانی از تصویر را برای همان حساب تأیید کنید.
- اگر ابزار تست نشده است، آن را فقط براساس مستندات معرفی کنید و رتبه کیفیت ندهید.
در این اجرای محدود، هر دو ابزار تستشده برای PDF فارسی ساده و متنی عملکرد قابل قبول داشتند. تفاوت مهم نه در پیدا کردن هفت عدد، بلکه در نوع بیان عدمقطعیت بود. برای کار واقعی، فایل خودتان، پرامپت ثابت و پاسخ معیار را نگه دارید؛ انتخاب قابل دفاع از یک آزمون تکرارپذیر میآید، نه از نام مشهور ابزار.
پرسش های متداول
بهترین ابزار خلاصه PDF فارسی کدام است؟
پاسخ ثابت ندارد. در آزمون محدود این مقاله ChatGPT و Gemini هر هفت واقعیت را درست استخراج کردند؛ انتخاب نهایی باید با فایل، حساب و معیار واقعی شما تکرار شود.
چطور توهم خلاصه ساز را پیدا کنیم؟
سؤالی نزدیک به موضوع بپرسید که پاسخ آن عمداً در سند نیست. ابزار باید نبود اطلاعات را صریح اعلام کند، نه اینکه عدد یا نتیجه تازه بسازد.
آیا همه ابزارها نمودار داخل PDF را می بینند؟
خیر. پردازش بصری به ابزار، مدل و نوع حساب وابسته است. مقدارهای نمودار را جداگانه با تصویر صفحه اصل کنترل کنید.