
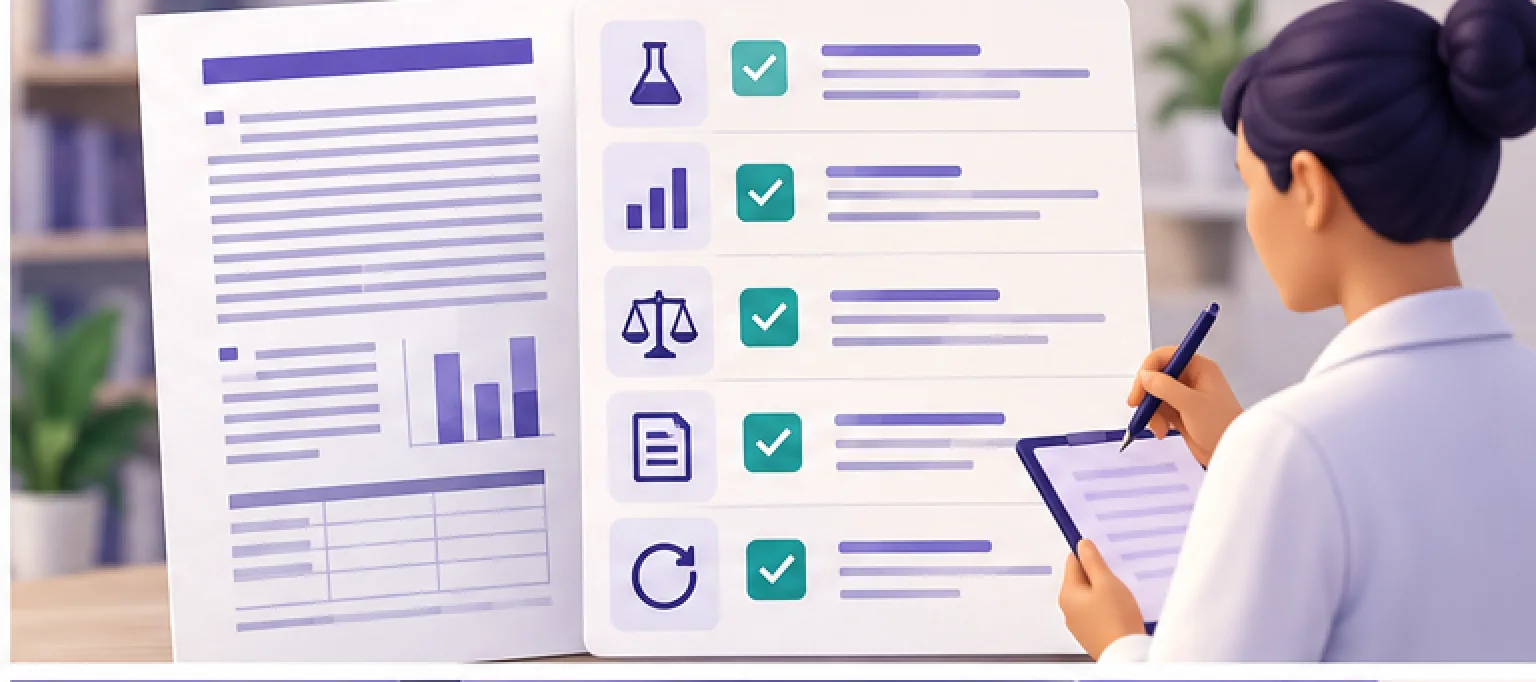
اعتبار مقاله علمی را با سؤال، طراحی، نمونه، Bias، Effect، فاصله اطمینان، Protocol، Funding و کاربردپذیری بسنجید.
اعتبار مقاله علمی با یک نشان مانند «Peer reviewed»، Impact factor یا تعداد Citation اثبات نمیشود. باید بپرسید سؤال چه بود، طراحی میتواند به آن پاسخ دهد، داده چگونه جمع و تحلیل شده و نتیجه تا کجا قابل تعمیم است. ارزیابی مقاله یعنی سنجش قوت شواهد برای ادعای مشخص، نه صدور مهر خوب/بد برای کل PDF.
چطور اعتبار یک مقاله علمی را بررسی کنیم؟
سه لایه را جدا کنید:
- هویت و وضعیت: مقاله واقعی، نسخه درست، Correction/Retraction؟
- اعتبار درونی: روش و تحلیل چقدر از Bias جلوگیری کردهاند؟
- کاربردپذیری: جمعیت، Context و Outcome با سؤال شما سازگارند؟
مجله معتبر میتواند مقاله ضعیف چاپ کند و مطالعه کوچک میتواند برای سؤال محدود مفید باشد.
گام صفر؛ هویت و وضعیت انتشار
- عنوان، نویسنده، مجله، سال و DOI را در ناشر و Crossref تطبیق دهید؛
- PubMed یا صفحه ناشر را برای Correction، Expression of concern و Retraction ببینید؛
- Preprint را با نسخه Journal اشتباه نگیرید؛
- Supplement، Protocol و Registration را پیدا کنید؛
- Funding و Conflict of interest را بخوانید.
وجود Funding صنعت مقاله را خودکار باطل نمیکند؛ پنهانکردن یا اثر آن بر طراحی/گزارش باید بررسی شود.
۱. سؤال و طراحی
سؤال را در یک جمله بازنویسی کنید. سپس ببینید طراحی متناسب است:
| سؤال | طراحیهای رایج مناسب |
|---|---|
| اثر مداخله | RCT یا quasi-experiment با Context |
| شیوع | نمونه مقطعی نماینده |
| پیشآگهی | Cohort با Follow-up کافی |
| تجربه/معنا | مطالعه کیفی با Sampling و تحلیل شفاف |
| دقت آزمون | مقایسه با Reference standard |
مطالعه مشاهدهای Association را میسنجد و بهتنهایی ادعای علت قوی را توجیه نمیکند.
۲. انتخاب نمونه و Comparison
- جمعیت هدف و معیار ورود/خروج چیست؟
- Sampling چگونه انجام شده و چه کسانی جا ماندهاند؟
- گروهها در Baseline چه تفاوتی دارند؟
- Comparator واقعی و همزمان است؟
- Attrition در هر گروه چقدر و چراست؟
نمودار Flow را با Table جمعیت تطبیق دهید. حذف شرکتکننده پس از دیدن Outcome میتواند Bias بسازد.
۳. اندازهگیری و اجرای مطالعه
- Exposure/Intervention دقیق و قابل تکرار است؟
- Outcome از قبل تعیین و معتبر است؟
- اندازهگیر از گروه یا فرضیه آگاه بوده است؟
- زمان سنجش برای دو گروه یکسان است؟
- Adherence، Co-intervention و داده گمشده گزارش شدهاند؟
Outcome جانشین را با نتیجه مهم برای بیمار/کاربر یکی نگیرید.
۴. تحلیل، Effect و عدم قطعیت
P-value تنها کافی نیست. اینها را استخراج کنید:
Effect measure:
Point estimate:
Confidence interval:
Absolute effect:
Adjusted variables:
Missing-data method:
Primary/secondary outcome:
Pre-specified or exploratory:
فاصله اطمینان گسترده یعنی داده با اثرهای بسیار متفاوت سازگار است. Statistical significance معادل اهمیت عملی نیست. در تحلیل تعدیلشده، بررسی کنید Confounderها براساس منطق ازپیشتعیین شدهاند یا انتخاب پس از نتیجه.
۵. Selective reporting و Spin
Protocol/Registration را با مقاله مقایسه کنید:
- Primary outcome عوض شده؟
- Time point نامطلوب حذف شده؟
- Analysis subgroup از قبل تعریف شده؟
- Abstract قویتر از Results حرف میزند؟
- عدم معنیداری به «برابری» تعبیر شده بدون طرح Non-inferiority؟
Reporting guideline مناسب را در EQUATOR پیدا کنید؛ PRISMA برای Review است، CONSORT برای RCT و STROBE برای مطالعه مشاهدهای. رعایت Checklist گزارش کاملتر را نشان میدهد، نه نبود Bias را.
۶. کاربردپذیری برای سؤال شما
حتی مطالعه معتبر ممکن است برای شما بیربط باشد:
- جمعیت و Setting مشابهاند؟
- Intervention در منابع شما قابل اجراست؟
- Outcome برای ذینفع شما مهم است؟
- Follow-up کافی است؟
- Benefit در برابر Harm و هزینه چگونه است؟
در ماتریس مرور ادبیات Effect، Context و Limitation را جدا ثبت کنید تا تعمیم ناخواسته رخ ندهد.
چکلیست ۱۲ سؤالی خواندن انتقادی
- ادعای اصلی دقیقاً چیست؟
- طراحی برای این ادعا مناسب است؟
- نمونه چگونه انتخاب شد؟
- Comparator مناسب است؟
- Measurement معتبر و یکسان است؟
- Biasهای اصلی کنترل شدهاند؟
- Attrition و missing data قابل قبولاند؟
- Effect و CI چه میگویند؟
- Protocol و Outcomeها سازگارند؟
- Funding/Conflict چگونه مدیریت شده؟
- نتیجه با Data سازگار است یا Spin دارد؟
- برای جمعیت شما چقدر کاربرد دارد؟
برای Review نظاممند، راهنمای PRISMA و ابزار Risk-of-bias متناسب با طراحی را جدا اجرا کنید. Citation صحیح طبق APA نیز اعتبار روش را تضمین نمیکند.
پرچم قرمز؛ نه حکم قطعی
- Journal یا ناشر ناشناخته با وعده پذیرش بسیار سریع؛
- Scope نامنسجم و Editorial board تأییدناپذیر؛
- داده و روش برای نتیجه بزرگ ناکافی؛
- ادعاهای علی از Survey مقطعی؛
- دهها Subgroup بدون اصلاح/Protocol؛
- Citationهایی که متن ادعا را پشتیبانی نمیکنند؛
- Figure تکراری یا عددهای ناسازگار؛
- نداشتن Raw data همیشه تقلب نیست، اما Reproducibility را محدود میکند.
پرچم قرمز ماشه بررسی است، نه اثبات تخلف. نگرانی جدی را با Editor/Institution از مسیر مناسب پیگیری کنید.
ثبت ارزیابی قابل بازبینی
در یادداشتهای نوتوا یا فرم پژوهش ثبت کنید:
Citation/DOI:
Claim being evaluated:
Design:
Main effect + CI:
Key bias:
Applicability:
Decision: use / use with caveat / exclude
Reason and page/table:
Reviewer/date:
پرسش های متداول
Impact factor بالا یعنی مقاله معتبر است؟
خیر؛ شاخص مجله است، نه ارزیابی روش هر مقاله. طراحی، Bias، Effect و تناسب ادعا را مستقیم بررسی کنید.
P کمتر از ۰٫۰۵ برای قبول نتیجه کافی است؟
خیر؛ اندازه اثر، فاصله اطمینان، طراحی، تعدد آزمون، اهمیت عملی و سازگاری با Protocol نیز لازماند.
Funding صنعت مقاله را باطل میکند؟
خودکار نه؛ Conflict، نقش Funders در طراحی/تحلیل/گزارش و سازگاری نتیجه با Data را بررسی و شفاف گزارش کنید.
جمعبندی
اعتبار مقاله از تناسب سؤال و طراحی، انتخاب نمونه، Measurement، کنترل Bias، Effect و عدم قطعیت ساخته میشود. نخست هویت و وضعیت انتشار را تأیید کنید، سپس ادعای مشخص را در برابر روش و Data بسنجید و در پایان کاربردپذیری را جدا تصمیم بگیرید. شهرت مجله یا ظاهر آماری میانبر امنی برای این مسیر نیست.